데이터베이스
데이터베이스는 구조화 된 데이터 관리 모듈 Tuya Developer Platform은 에이전트를 제공합니다. 에이전트 저장소, 읽기, 업데이트 및 삭제 데이터를 삭제, 자연 언어 또는 시스템 논리에 의해 구동.
데이터베이스를 사용하면 이러한 기능을 제공 할 수 있습니다.
- 기록 사용자 행동 및 로그.
- 개인 프로필 및 선호도 저장.
- 여러 사용자들 사이에서 공유된 데이터를 관리합니다.
- 비즈니스 지식베이스 및 백엔드 데이터 테이블 구축.
플랫폼은 협업 공유에 대한 개인 상호 작용에서 세 가지 데이터 모드를 제공합니다.
- ** 단일 사용자 모드**: 각 사용자는 독립적인 자료 공간을 비치하고 있습니다.
- ** 다중 사용자 모드**: 사용자는 동일한 dataset에 공유하거나 협력합니다.
- 개발자 모드: 개발자는 백엔드 데이터를 유지합니다. 사용자는 쿼리만 사용할 수 있습니다.
데이터베이스 모드
| 주요 특징 | 일반적인 시나리오 | Data type 및 읽기/쓰기 논리 | 이름 * |
|---|---|---|---|
| ** 단일 사용자 모드 ** | 개인 데이터 기록, 동반자, 성장 앱. 사용자별 기억, 학습 로그 및 건강 기록. | Data type: user-private data. Read/write 논리: 소유자 만 만들 수 있습니다, 수정, 또는 삭제 데이터. **졸작 **: 데이터는 사용자 ID, 제품 ID (PID) 및 에이전트에 의해 격리되어 있으므로 사용자, 에이전트 또는 PID를 방해하지 않습니다. | ** AI 장난감 **: 매일 학습 및 성장 이벤트를 기록합니다. "오늘은 블록을 구축하는 것을 배웠습니다. · AI 일기 조수: 감정, 감정, 일일 계획 기록. Spending Tracker: "Spent ¥35 오늘"과 같은 기록과 통계를 생성합니다. |
| ** 다중 사용자 모드 ** | 공유 및 상호 작용 시나리오. 작업 보드, 협업 상호 작용 및 소셜 메시지 보드. | Data type: 공개 또는 그룹 공유 데이터. Read/write 논리: 다중 사용자는 데이터를 쓸 수 있습니다. 동화: 여러 장치와 사용자의 실시간 업데이트. | Bottled 메시지: 모든 사용자는 메시지 풀, 임의로 그림 메시지를 공유하거나 새 사람을 제출합니다. AI 작업 광장: 사용자 기록 일일 작업 완료 및 전망 순위. 클래스 학습 리더보드: 모든 회원들의 작업 완료율과 포인트를 표시합니다. |
| 개발자 모드 | 지식 관리 및 중앙화 된 데이터 유지 보수. 제품 정보, 책 Q&A 및 FAQ 시스템. | Data type: 개발자에 의해 획일하게 유지. Read/write 논리: 개발자는 데이터를 작성하거나 업데이트 할 수 있습니다. 사용자는 쿼리 할 수 있습니다. Permission 제어: 에이전트는 읽기 전용 액세스. | ** 제품 정보 에이전트**: 백엔드의 제품 매개 변수와 설명을 가져옵니다. 사용자는 Q&A. Library Assistant를 통해 쿼리합니다. 질문 책 저자, summaries 및 상태. 기업 지식 베이스: 사업 지식과 정책 문서를 관리합니다. |
예제
다음 예제는 실제 에이전트 시나리오에서 세 가지 모드의 전형적인 용도를 보여줍니다.
단일 사용자 모드
| 예제 및 설명 | 대화 예 |
|---|---|
| **AI 장난감 / 성장 추적기 **: 매일 학습 및 상호 작용을 기록하기 위해 사용자 당 독립적 인 데이터 테이블을 만듭니다. | 사용자 : "오늘 블록을 구축하는 것을 배웠다. · Agent: "Recorded: 오늘 학습 작업-블록 구축!" |
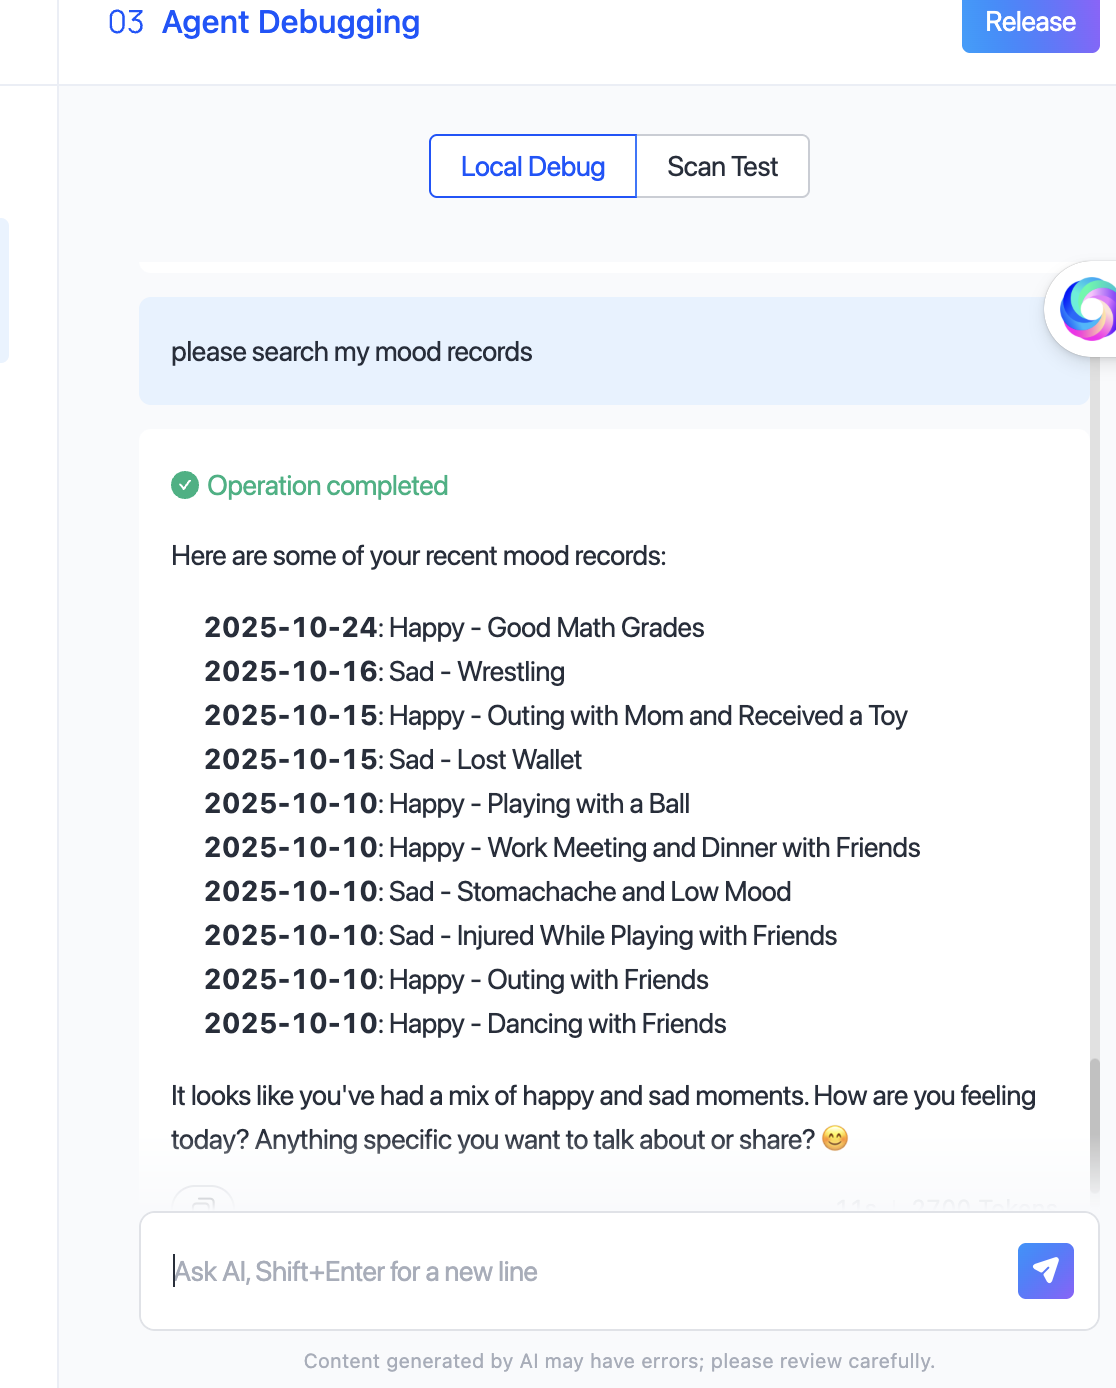
| AI 레코더 / 일기 조수: 사용자 기록 회의, to-do lists, or mood logs by voice or text. 데이터는 사용자에게만 표시됩니다. | 사용자: "회의 키 포인트: 금요일에 의해 새 문서를 제출합니다. · Agent: "Task 녹음: 새 문서를 제출." |
** 일기 카드의 샘플 인터페이스**:
멀티 유저 모드
| 예제 및 설명 | 대화 예 |
|---|---|
| **AI 작업 광장 **: 다중 사용자는 작업 데이터 테이블을 공유합니다. 시스템은 작업 완료율과 순위를 자동으로 계산합니다. | 사용자 : "나는 오늘 두 권의 책을 읽었습니다. " Agent : "우수! 작업 완료율은 오늘 100 %, 현재 3 위입니다. " |
| Bottled 메시지 / 공개 게시판: 사용자가 공개 테이블에 메시지, 다른 사람이 무작위로 볼 수 또는 응답 할 수 있습니다. | 사용자 : "나는 다음 사람에게 메시지를 남기고 싶습니다 : 행복하게 유지하십시오. · Agent: "메시지 전송! 나중에 받은 것을 볼 수 있습니다." |
개발자 모드
| 예제 및 설명 | 대화 예 |
|---|---|
| ** 제품 Q&A 대리인 **: 개발자는 백엔드에서 제품 정보 (특정, 기능 및 FAQ)를 유지합니다. 에이전트 쿼리 및 대화 중 결과를 반환합니다. | 사용자 : "이 빛은 Wi-Fi를 지원합니까? " Agent: "예, 그것은! 이 제품은 2.4 GHz Wi-Fi 연결을 지원합니다." |
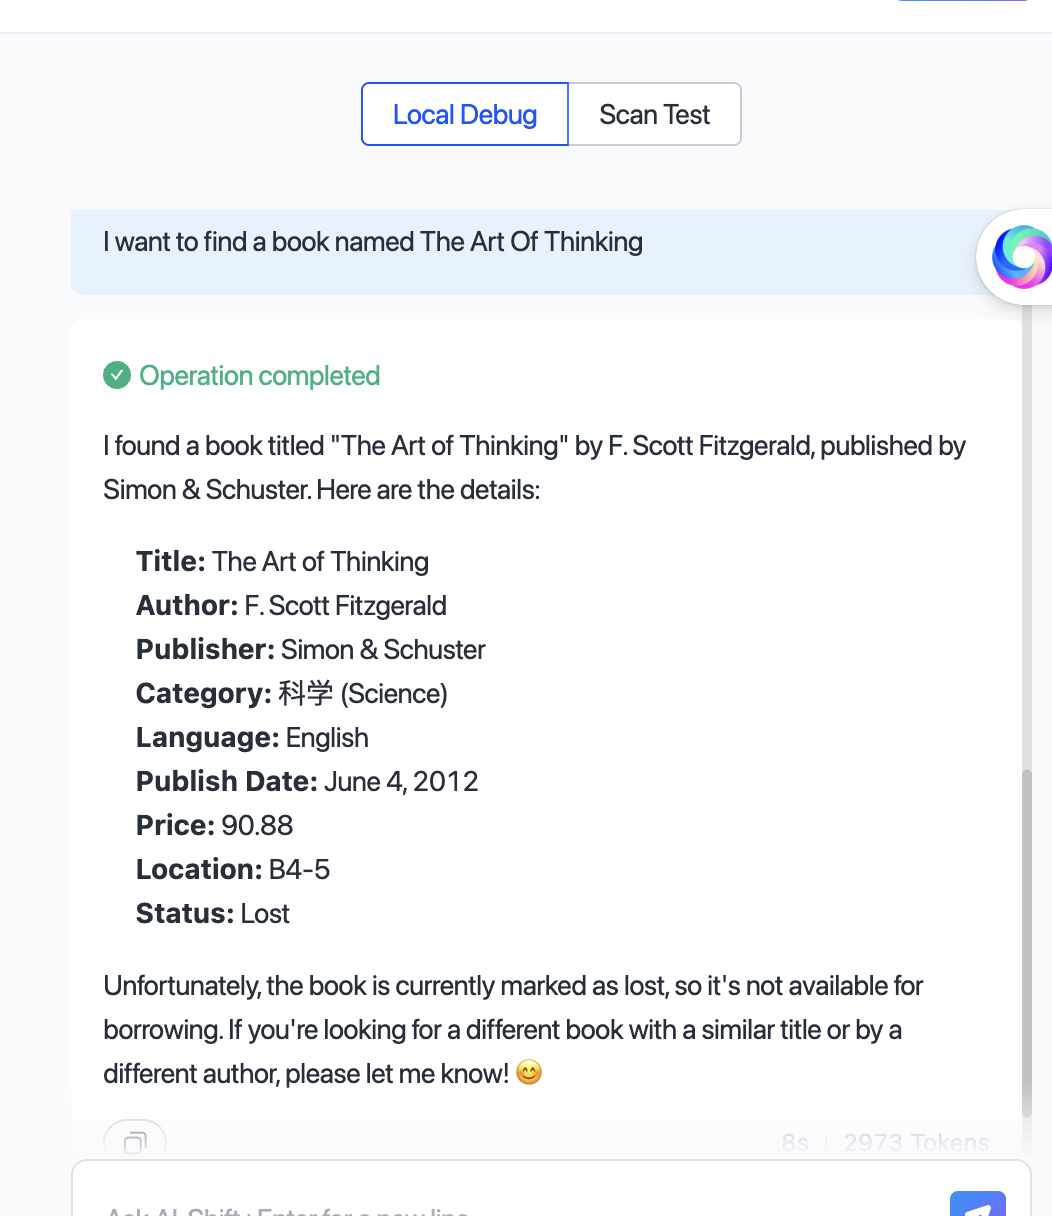
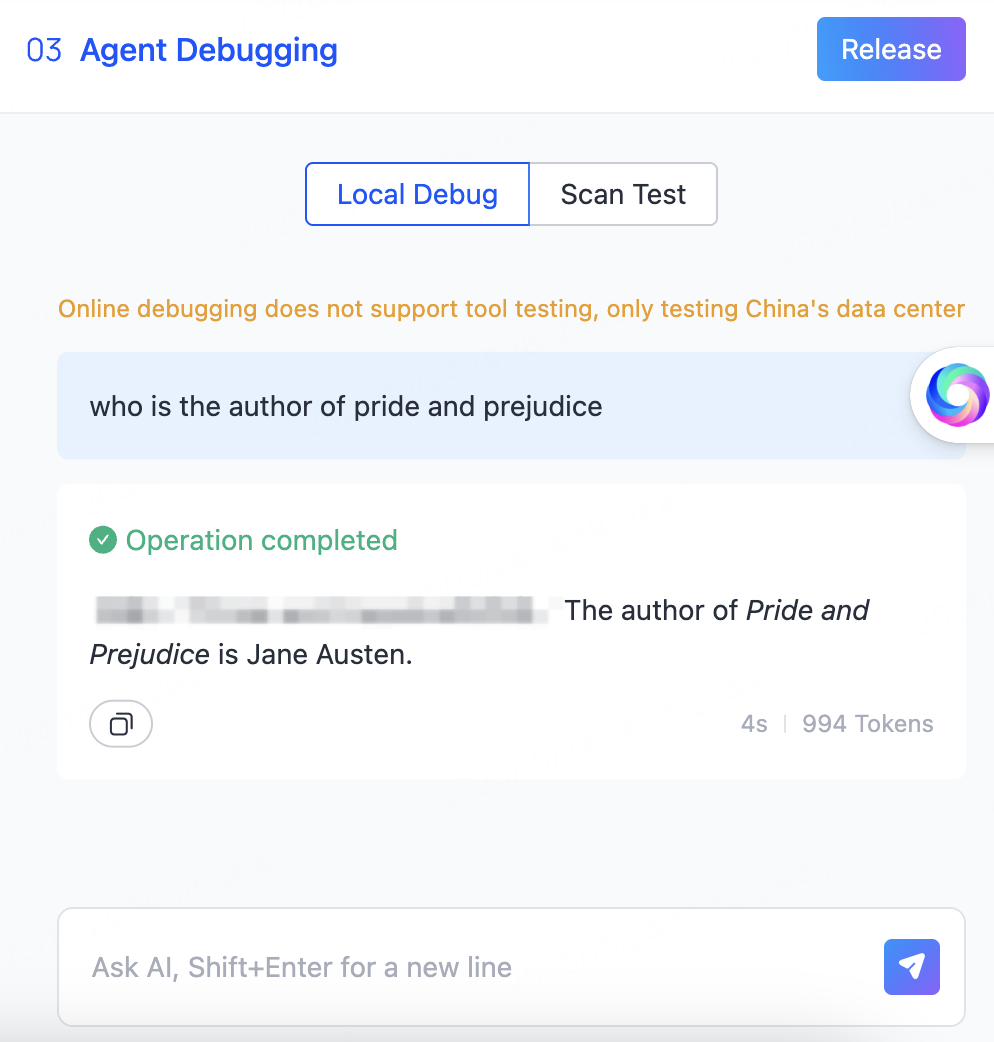
| ** 도서관 보조**: 책 정보는 백엔드에 유지됩니다. 사용자는 Natural-language 쿼리를 통해 검색합니다. | 사용자 : "Sapiens의 저자를 확인하십시오 : 인류의 짧은 역사. " Agent: "Sapiens: 인류의 짧은 역사는 Yuval Noah Harari입니다." |
**library AI 조수의 샘플 인터페이스 **:
데이터 가져 오기 및 테스트
| 제품 정보 | 단일 사용자 모드 | 다중 사용자 모드 | 개발자 모드 |
|---|---|---|---|
| Test data 가져오기 | 지원되지 않음 | 지원되지 않음 | 지원되는 |
| 온라인 데이터 가져 오기 | 지원되지 않음 | 지원되지 않음 | 지원되는 |
Data import는 Developer mode에서만 사용할 수 있으며 프로젝트 관리자가 수행해야 합니다.
절차
데이터베이스 만들기
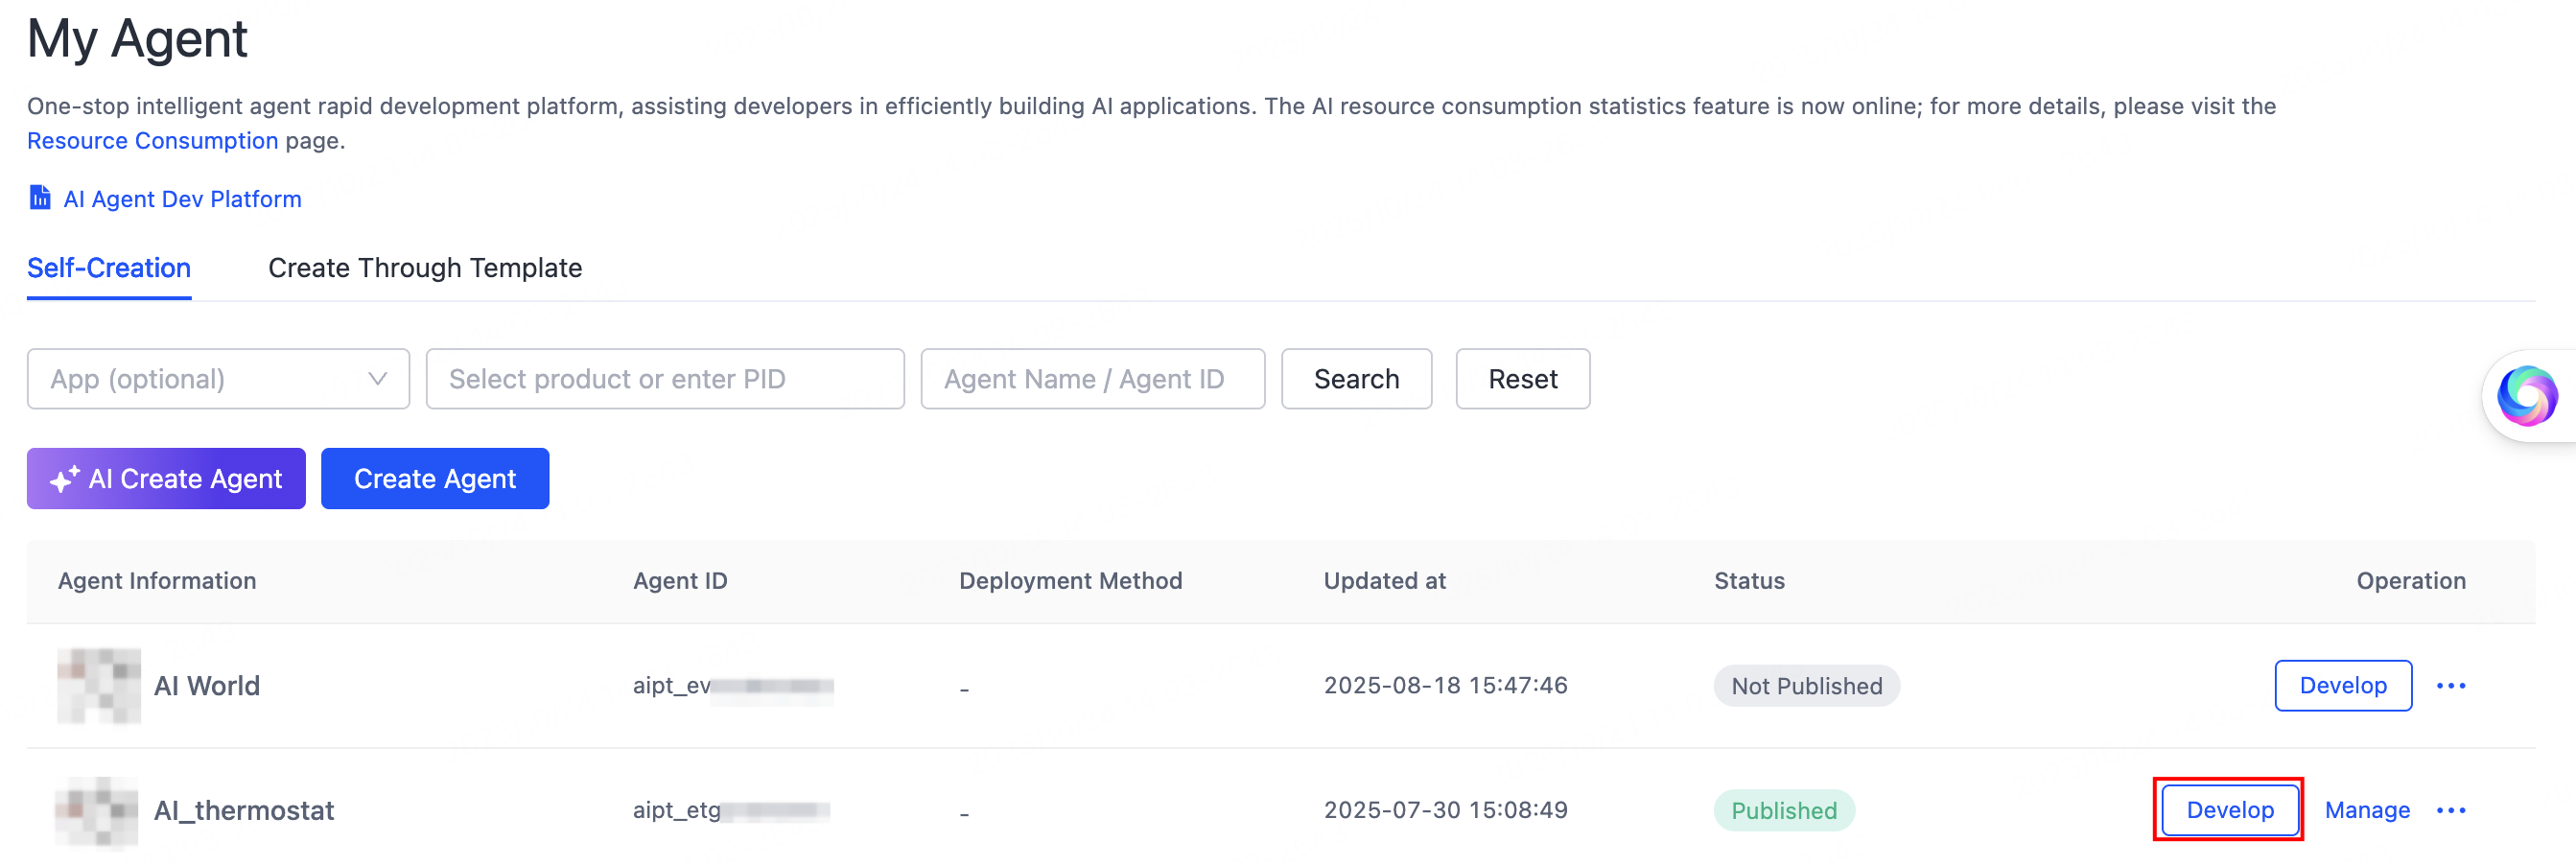
- My Agent 페이지로 이동하여 Operation 에이전트의 열을 클릭합니다.
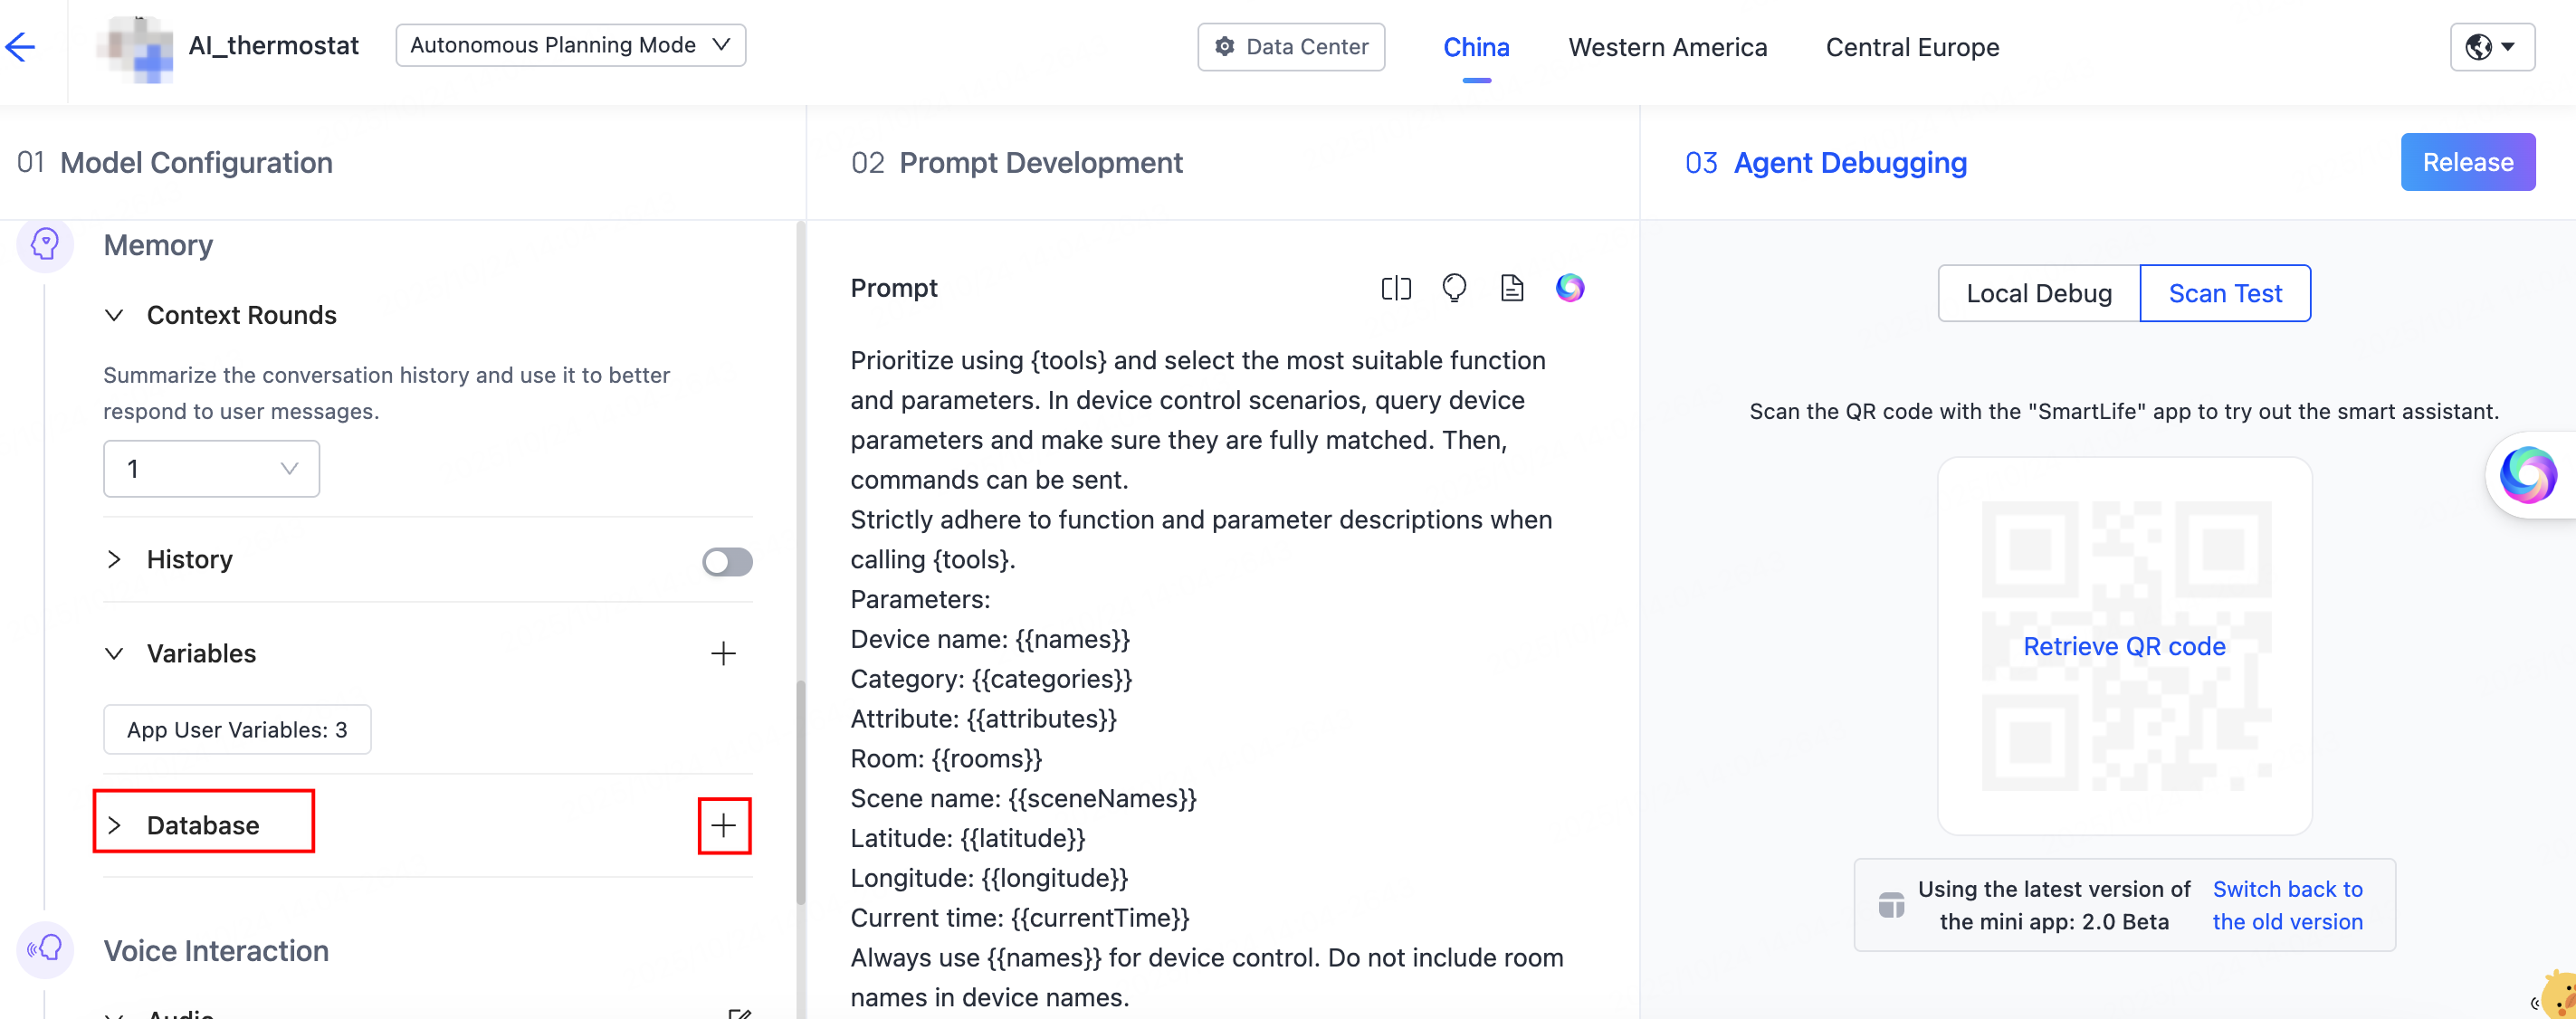
- Model Configuration > Memory, find Database, then click the add (+) button on the right.
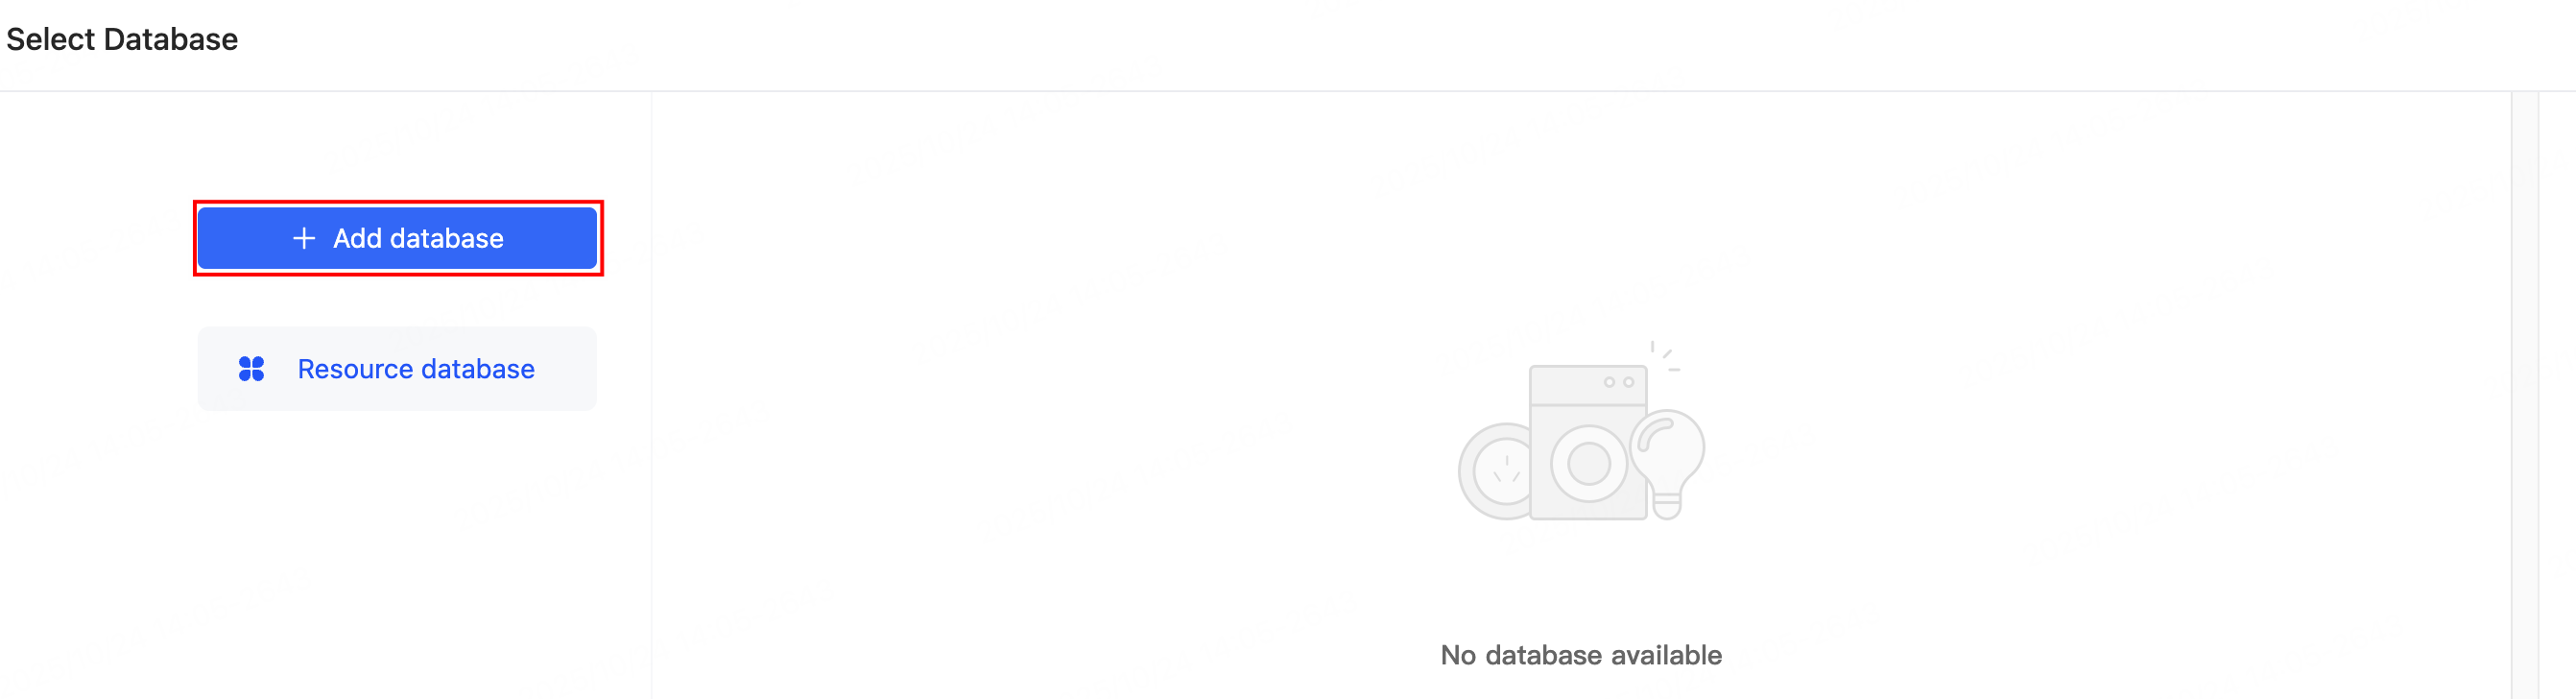
- ** 데이터베이스 선택** 페이지, click Add database in the top-left corner, 또는 오른쪽의 목록에서 기존 데이터베이스를 바인딩.
- 데이터 테이블 구조를 정의합니다. 에이전트의 사업 유형에 따라 테이블 유형, 설명, 필드 및 기타 관련 정보를 정의합니다.
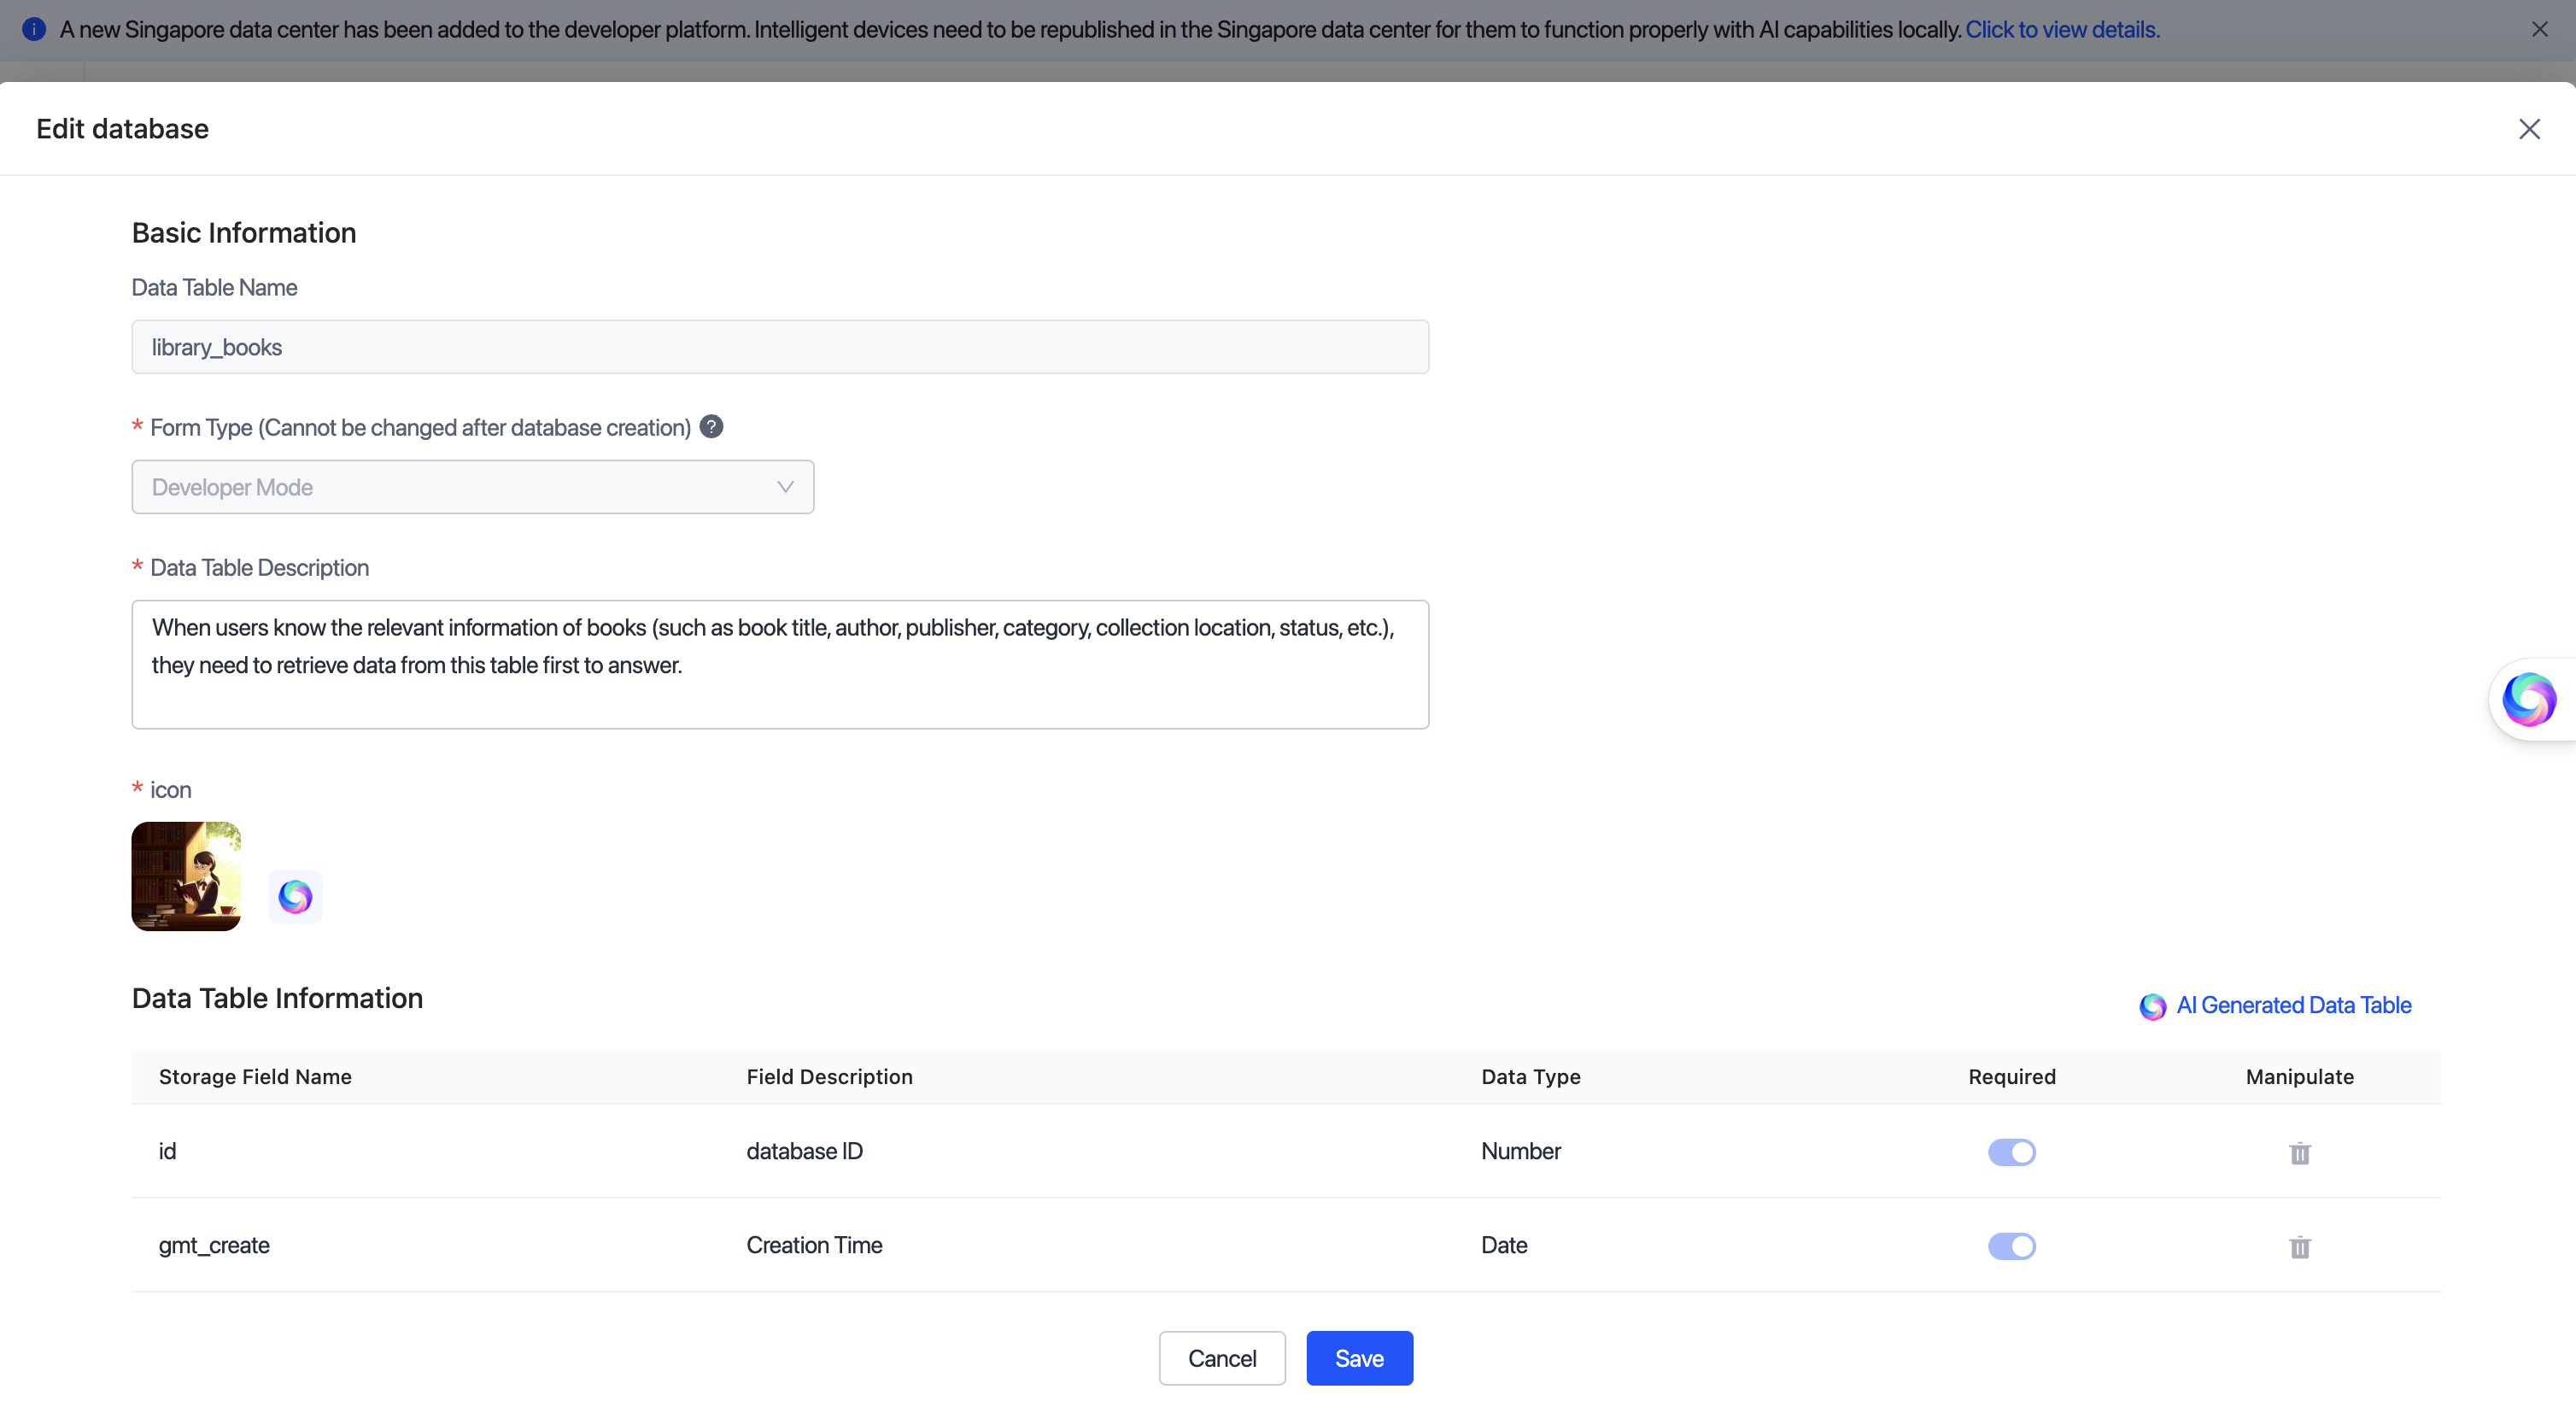
- AI는 semantics에서 데이터베이스 구조를 제공합니다.
- 더 구체적인 설명은 필드 이름, 목적 및 데이터 유형을 포함하여 더 정확한 구조를 산출합니다.
- Multi-turn 대화는 당신에게 정밀한튠 필드 구성을 할 수 있습니다. 시스템은 실시간 구조 정의를 업데이트합니다.
- 양식을 작성한 후 Save를 클릭합니다. 시스템은 테이블 구조를 자동으로 초기화합니다.
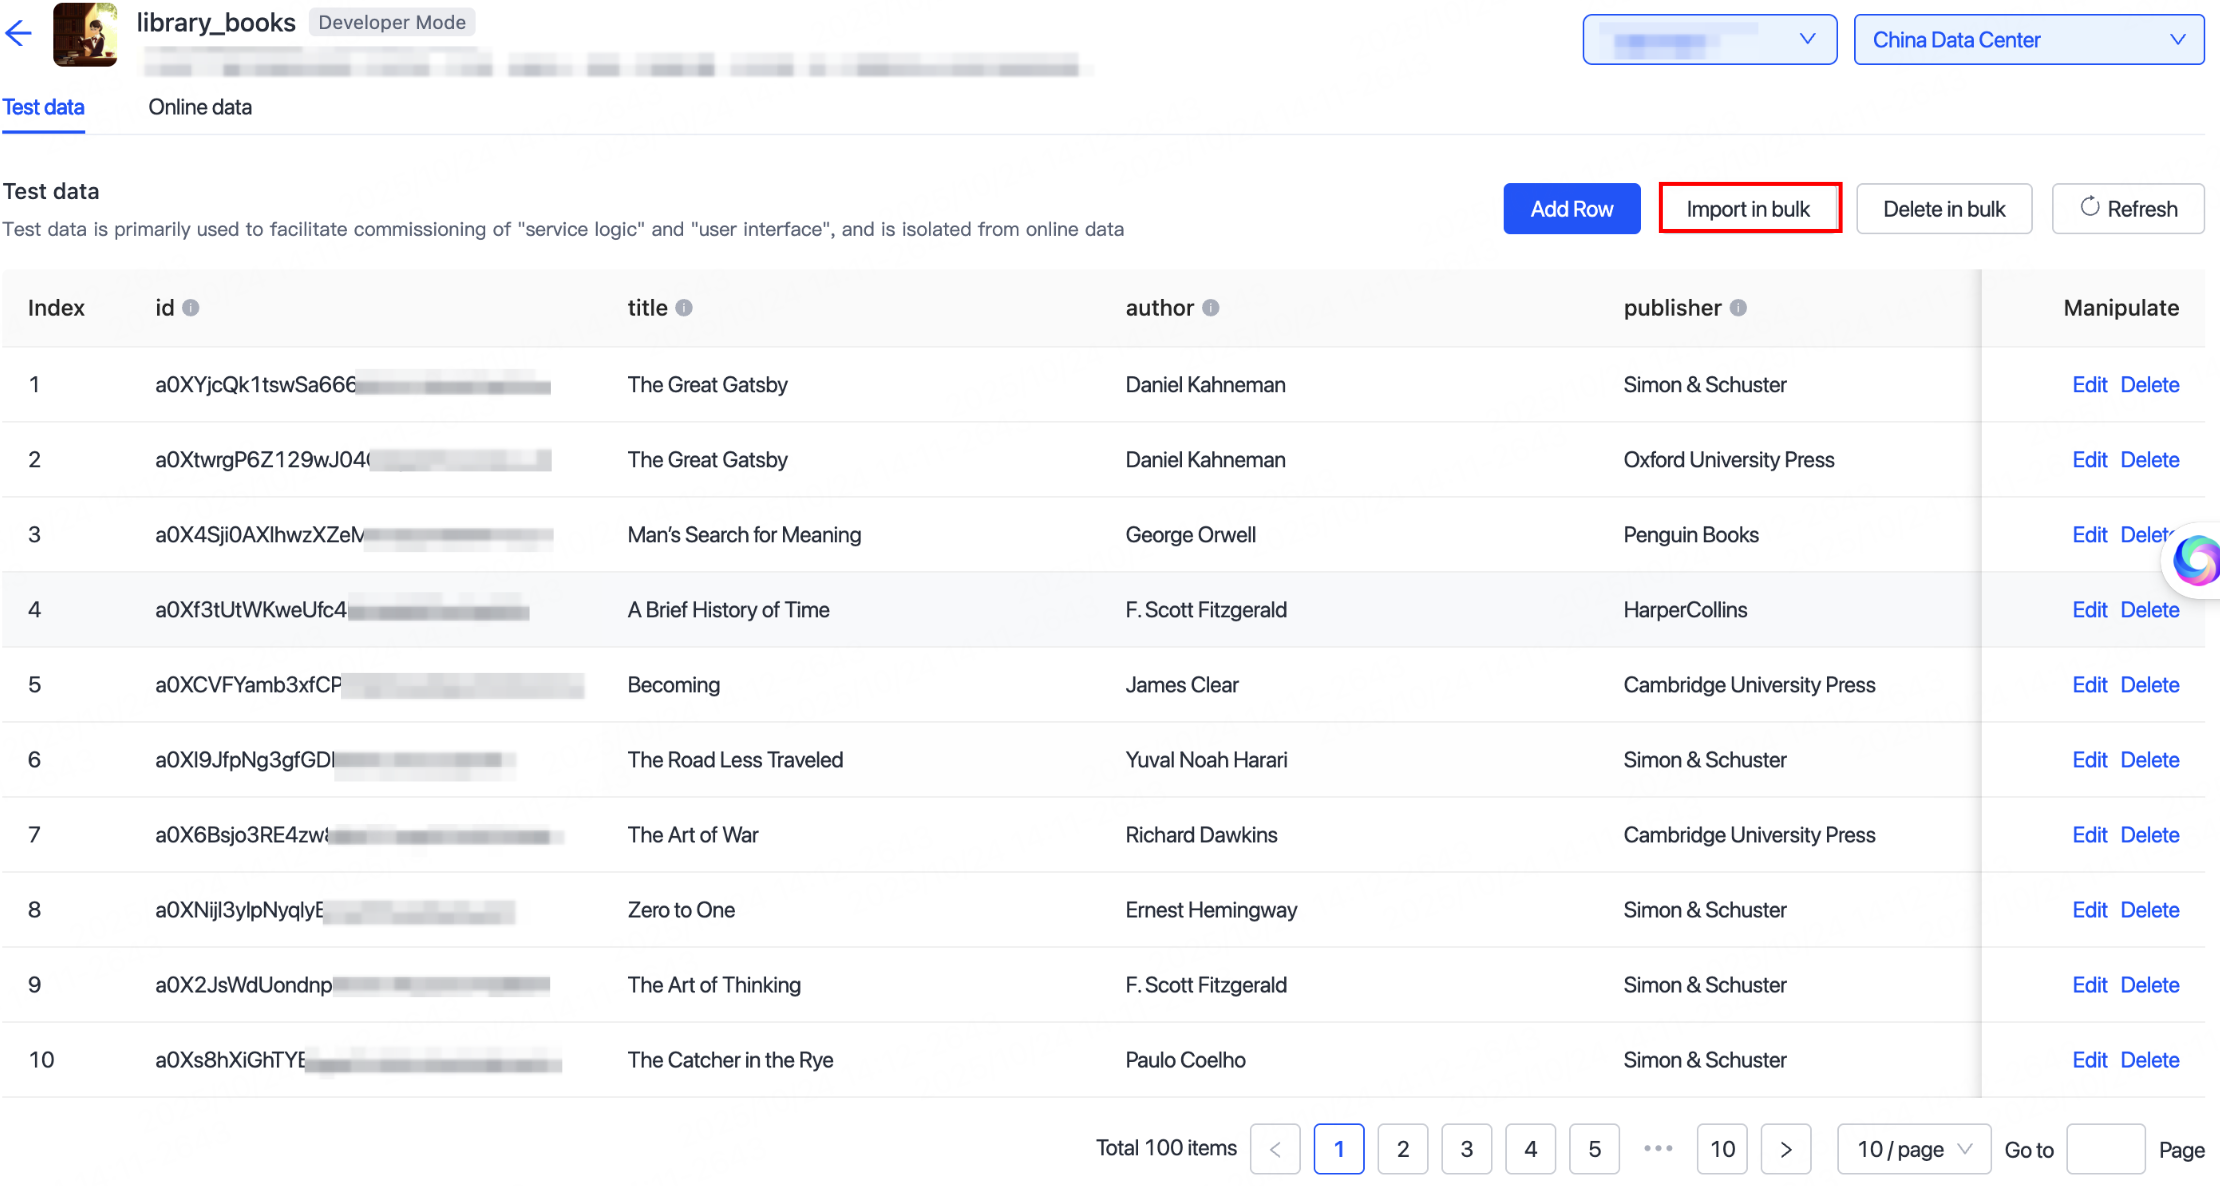
**개발자 모드 **, 당신은 클릭 할 수 있습니다 ** 대량의 손상 ** 테스트 샘플 데이터를 가져올 수 있습니다.
테스트 및 디버그
Agent Debugging 단계에 대해 설명합니다. QR 코드를 스캔하거나 온라인 디버깅을 사용하여 대화 응답을 확인합니다.
정확한 에이전트가 데이터베이스를 호출하는 방법에 영향을 미치는 주요 요인은 다음과 같습니다.
- **데이터베이스 및 필드 설명 **: Clearer descriptions는 AI가 데이터의 목적과 구조를 이해하는 데 도움을 줍니다.
- ** 에이전트 프롬프트의 데이터베이스 사용 규칙 **: 시나리오가 쿼리 또는 쓰기를 트리거해야 하는 프롬프트에서 정의, 관련 예제와 함께, AI가 올바른 데이터베이스 동작을 자동으로 선택합니다.
참조
- [AI 제품 명령] (9-ai-product-commands)
- 지원 언어 및 음성 배리어
- Custom Voice 추가